2026Agent智能体如何自动执行数据治理任务?2026年,数据治理正在从企业的"后台职能"走向"前线战场"。IDC在《Data Agent市场图谱,2026Q1》里给出一个判断:到2028年,六成中国500强企业将部署企业级Data Agent;到2026年,一半企业会把数据分析Agent用于自动化日常任务。换句话说,"Agent自动执行数据治理"已经不是CTO们的PPT课题,而是正在落地的生产范式。
这篇文章会把"2026 Agent智能体自动执行数据治理任务"这件事讲透——它到底是什么、为什么2026这个时间节点突然爆发、Agent到底怎么干活、主流厂商和案例长什么样,以及你最关心的落地路径和ROI怎么算。
什么是"Agent自动执行数据治理"?先把这个概念掰开
传统数据治理的画风你大概率见过:数据专员人工盘点资产、标准管理员对着Excel比对口径、质量工程师手写SQL检核规则、发现问题再发邮件催办……高度依赖人,天花板就是人。
而2026年讲的 Data Agent(数据智能体),不是"你问一句它答一句"的AI助手,而是一套 "感知 → 决策 → 执行 → 学习"的闭环系统:
感知层:实时采集数据库日志、API调用、用户操作行为,相当于给数据系统装了一套全天候神经系统
决策层:大模型 + 规则引擎 + 私域知识库,判断"这条数据合不合规 / 要不要修 / 口径冲不冲突"
执行层:自动触发动作——发告警、阻断操作、调度清洗任务、一键落标
学习层:从历史事件里持续优化策略,越用越聪明
举个具体画面:你对系统说一句"把这套系统的客户表按金融行业标准落标",资源盘点Agent先扫源系统生成台账,标准设计Agent按行业规范推荐数据元定义,模型规划Agent直接给出数仓分层建议——整套流程自动跑完,不用你在菜单里翻功能入口。
一句话区分:传统治理是"人找问题",Data Agent是"智能体主动发现问题 → 判断 → 执行",人在环(Human-in-the-loop)而不是人在干。
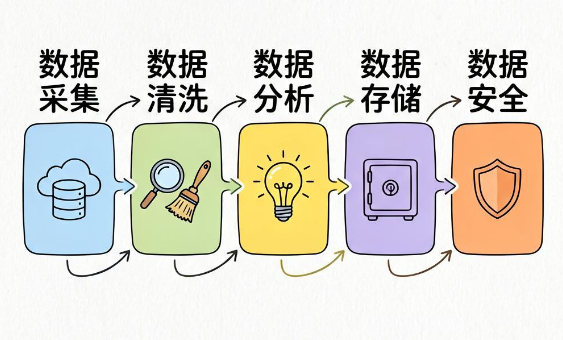
为什么是2026?三个信号说明范式切换已经发生
信号1:大模型终于能"读懂"语义了
数据治理最大的痛点是跨系统口径不一致、元数据靠人工维护、百万级字段没人理。2026年这一代Agent能把数百万分散物理字段收敛到万级标准业务术语,建起跨系统语义映射——这事以前靠人海战术十年都理不完。
信号2:效率不是"加法"是"乘法"
很多人对AI提效的理解还停在"原来1小时现在45分钟"。但百分点AI-DG的实测数据是:
数据集成效率较传统模式 提升80%
治理交付周期平均 缩短70%
用友那边更激进:16个专业Agent覆盖从调研到清洗全过程,"AI生成初稿、人工审核确认",人力成本降约70%。这不是渐进改良,是生产方式重构——从计算器变电子表格那种级别。
信号3:厂商格局2026年已经成型
某经济新闻网6月那份六大Data Agent产品横向测评(百分点AI-DG、腾讯云WeData、火山引擎DataLeap、微软Purview、用友BIP、金蝶云苍穹)已经把赛道切清楚了。"智能化深度 / 平台开放度 / 行业积累"成了选型的三个硬指标,说明市场已经进入比拼工程化能力的阶段,不是概念期。
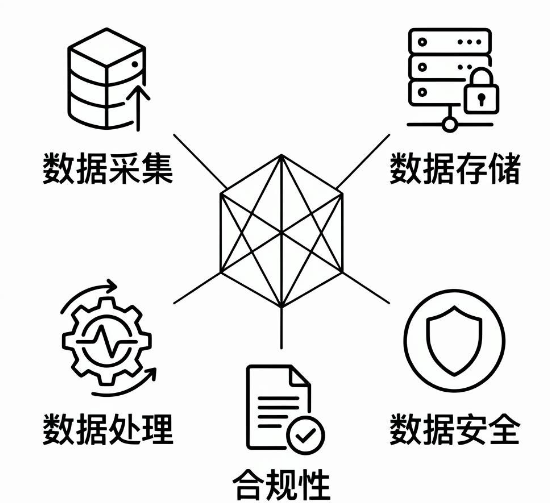
Agent到底怎么自动执行数据治理?五类角色拆解
落到"干活"层面,一个成熟的数据治理智能体集群,通常是多Agent协同而非单个万能Agent。对照2026年已发布的产品(睿治Agent九大能力、用友16个专业Agent、百分点多Agent架构),可以拆成五类角色:
1. 资源盘点 Agent
自动扫描源系统(数据库、数据湖、API、甚至非结构化存储),生成资产台账 + 敏感度标签 + 负责人推断。某银行三周上线敏感数据外发拦截场景,首月阻断12次违规操作,合规风险下降九成——第一步就是盘点Agent先把"有哪些敏感字段在哪"搞清楚。
2. 标准设计 Agent
吃进行业规范文档(金融/医疗/制造各有各的标准),自动推荐数据元定义、业务术语、指标口径。原来标准管理员和开发反复对齐要好几天,现在一次对话闭环。
3. 数据质量 Agent
事前:智能数据体检,无人工干预下自动推荐质检规则,直接生成SQL或正则
事中:规则管理 → 问题检核 → 整改追踪全程贯通,自然语言描述就能生成规则
腾讯云在保险场景的评估是"50%以上的数据质量问题在开发过程中产生"——质量Agent就是要在开发期就把住,而不是事后救火
4. 数据集成 Agent
自然语言定义集成任务,比如"把ERP的供应商表和CRM的客户表按税号打通"——Agent自动生成Mapping、调度任务、处理冲突。配置门槛从"要会写SQL"降到"会说话"。
5. 血缘与影响分析 Agent
自动维护业务级 + 技术级血缘图谱。你问"用户表改个字段会影响哪些下游报表",Agent立刻把链路拉出来。Cortex那个统一目录案例里,数据血缘+AI血缘+决策血缘三类实时跟踪,是Agent自治的标配能力。
这五类Agent不是孤立的,它们共享一个东西——统一元数据目录(SSOT)。没有SSOT,Agent再多也是瞎忙。Apache Gravitino、TC-Catalog、Unity Catalog 这类统一目录,是2026年Data Agent能跑起来的地基。
2026年主流玩家与落地案例(选型前必看)
落地路径上,一个被反复验证的节奏:
单场景切入:选"敏感数据外发拦截""字段级血缘追溯"这种边界清晰、价值可见的小场景,3-4周上线
横向扩展:扩展到质量异常检测、元数据变更通知
全链路覆盖:建模 → 标准 → 质量 → 集成 → 安全 → 血缘,多Agent协同
别一上来就想"全行治理"——那是2018年的失败剧本,2026年还这么干必坑。
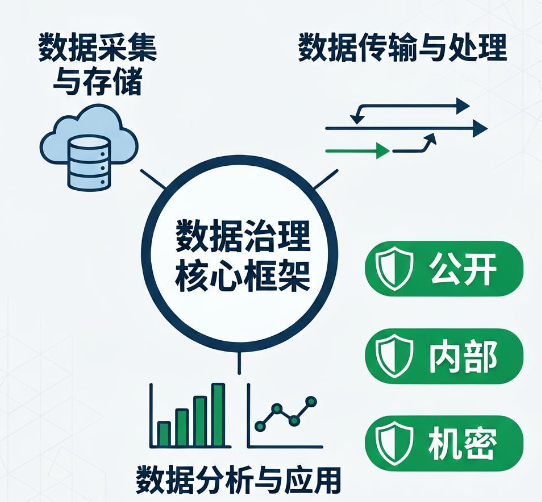
FAQ:People Also Ask 高频问题
Q1:Data Agent和传统数据治理平台到底差在哪?
A:传统平台是"规则驱动的管理工具"——人配规则、人查异常、人点按钮;Data Agent是"AI驱动的智能协同中枢"——感知到异常→大模型判→自动执行→自我迭代,人只在例外情况介入。一个是"更顺手的扳手",一个是"会自己拧螺丝的工人"。
Q2:ROI怎么算?中小团队上得起吗?
A:可量化的几类指标——Time to Value(治理交付周期,实测-70%)、人力成本(AI初稿模式下-70%)、合规事件数(某银行首月-90%)、数据复用率("生产即治理"模式下提升显著)。中小团队不建议自研,优先选零代码/低代码Agent构建的SaaS形态(如睿治Agent、Collate托管OpenMetadata),单场景切入几十万预算能跑起来。
Q3:Agent自动执行会不会和安全/合规冲突?
A:反了,Agent是强化合规的。执行层所有动作都过统一元数据层的鉴权(Gravitino那套思路),敏感字段的查询、外发、清洗全程留痕;而且"敏感数据外发拦截"本身就是Agent最成熟的第一个场景。但要留人在环——最终审批、重大删除/外发操作建议保留人工confirm,别全交给Agent背锅。
Q4:我们数据底座还比较乱,能直接上Agent吗?
A:能上,但建议先补统一元数据目录这一层。多家实践都提到:Agent的前提是SSOT,不然大模型拿到的schema都是散的,NL2SQL也收不了权限口子。如果连目录都没有,第一步是"资源盘点Agent + 统一目录"一起上,让它自己先把家底理清楚——这也算是Agent的"自举"。
回到标题那句话——2026 Agent智能体如何自动执行数据治理任务? 答案已经不是"未来展望",而是"工程化落地":
是什么:感知-决策-执行-学习的闭环系统,多Agent协同替代人海梳理
为什么是2026:大模型语义理解到位 + 效率乘法验证(集成+80%、周期-70%、人力-70%)+ 六家主流厂商格局成型
怎么做:五类Agent(盘点/标准/质量/集成/血缘)围着统一元数据目录协同,单场景切入→扩展→全链路
给谁用:中国500强里2028年六成会部署,但现在2026年"一半企业"已经在试分析Agent——再晚一步,差距就不是工具差,是生产方式差了
数据治理的终局,不是一套软件,而是一个持续运行的智能体。2026年,是"人治"让位给"智治"的拐点年份——你所在的团队,准备从第几个场景切入?
猜你喜欢















